2016年6月6日月曜日


2016年5月29日日曜日
2016年5月27日金曜日
2016年5月26日木曜日
2016年5月24日火曜日
ノイマンの自然数の生成の話
もう一発小ネタです。
これがなかなか手こずりました。
いや、アルゴリズムが、って意味じゃなくって計算速度がなかなか上がらんキッツい問題だな、と言う意味です。
さて、これは定義上は、見かけはビックリするんですが、実は実装的にはPythonのrange関数(あるいはSchemeのSRFI-1のiota)の再実装みたいなモンです。
つまり、入力nに対して何を返すのか、と言うと実は
仮に、Schemeでこういう、ちょっとダウングレードなカンジのrangeなりiotaを実装するのは鼻クソでしょう。
ところが、です。
これが0を空リスト、と定義したらちと厄介な事になる。
末尾再帰で書いてるんですが、問題に書かれてるn = 0〜3付近の数ならイイんですが、一方、nが10、20、30と増えていくと、計算がどんどん時間かかっていって、100辺りになると終わらないんですね〜。
ロジック的にはどっちも同じなのに計算時間が物凄くかかる、ってのは、後者は空リストのconsを生成してるだけなんだけど、それで膨大な、恐らくヒープを消費してニッチもサッチもいかなくなってくる、って事です。要するに巨大なガベージを生成してるに他なりません。
実は最初は、遅延評価で書けばどうなんだ、とか思って書いてたんですが、これもnが増大するととんでもない事になっていきます。
多分「定義のクールさ」って意味ではこの遅延評価版が一番カッコイイでしょう。見た目も綺麗ですし。マトモに定義通りに返してくれますし。
ところがさすがの遅延評価版でもnが100とかなると計算が終わりません。やはりどっかで大量のconsを扱うのが大変になるんですね〜。
さて、だったらメモ化はどうだ、って話になるんですが。
通常の高階関数のメモ化を利用して・・・ってのはこの場合は上手くないんです。
基本的に、n = 100を計算する時、n = 100の答えがあったらそいつをハッシュから持ってくる、ってのがメモ化の極意なんですが、生憎、フツーに実装したら今回のような「n = 100の状態を計算する為にはn = 99が必要」のケースだと上手く計算を省略してくれないんですよね。
理想的には再帰的にnを探ってくウチに得た値を利用して計算を行う、と言うちょっとした手動的な最適化が施されてないと、結局毎回新たな値を与える度にn=0まで到達してしまう。
今回のノイマンのモデルだと、どっちにせよnは順番に並んでますし、例えばn = 10を何の情報も無い状態で計算した際にn = 0〜10までのハッシュを全部記録して、n=11の計算の際にn=10「だけ」利用すれば11がすぐ得られる、と言う最適化を施しておいた方が良いわけです。
また、n=11まで計算した後で、n=15を計算するとn=12〜14までの情報は無いわけですが、ハッシュを手繰っていって、n=11の値が見つかった際にそこから計算をスタートしてn=12〜14までをハッシュに埋めつつn=15を返す、ってカタチにしておけば、0まで戻る無駄は省けるわけです。
今回はSRFI-69のハッシュテーブルを利用しています。
ローカル関数のgetはnが与えられた時、nに対応するvalueがハッシュ内にあるかどうか検索します。nが見つからなかった時にはn-1を検索、それでも見つからない場合は・・・と小さいキーを順次検索していって、valueが見つかった時、そのキーを返します。
ローカル関数putは逆に、あるキーからnに向けて計算した数値を逐次ハッシュに記録していって、キーがnと同じになった時にvalueを返して脱出します。
この2つのローカル関数で、ノイマンの定義を最適化するように試みてるんですが・・・・・・。
それでもやっぱn=100とかだと計算時間かかりすぎて、っつーかやっぱどうもヒープ食いつぶして上手い具合にいかないですねぇ。
ハッキリ言って、この問題は、「計算スピードの省略」じゃどうにもならなくって、どっちかっつーとメモリ容量との戦いの模様です。
なかなかconsは手強いですよ。
#数学の問題 #プログラミング— 結城浩 (@hyuki) May 17, 2016
ノイマンの方法で非負整数を作る。
0 = {}
1 = {{}}
2 = {{},{{}}}
3 = {{},{{}},{{},{{}}}}
…
あなたの好きなプログラミング言語で作ってみよう!
これがなかなか手こずりました。
いや、アルゴリズムが、って意味じゃなくって計算速度がなかなか上がらんキッツい問題だな、と言う意味です。
さて、これは定義上は、見かけはビックリするんですが、実は実装的にはPythonのrange関数(あるいはSchemeのSRFI-1のiota)の再実装みたいなモンです。
つまり、入力nに対して何を返すのか、と言うと実は
1を入力 -> [0]を返すってのと全く同じ事をしてるんですね。ただ、最初に0を[]と定義してるだけ、なんで仕組みは簡単なんです。
2を入力 -> [0, 1]を返す
3を入力 -> [0, 1, 2]を返す
仮に、Schemeでこういう、ちょっとダウングレードなカンジのrangeなりiotaを実装するのは鼻クソでしょう。
ところが、です。
これが0を空リスト、と定義したらちと厄介な事になる。
末尾再帰で書いてるんですが、問題に書かれてるn = 0〜3付近の数ならイイんですが、一方、nが10、20、30と増えていくと、計算がどんどん時間かかっていって、100辺りになると終わらないんですね〜。
ロジック的にはどっちも同じなのに計算時間が物凄くかかる、ってのは、後者は空リストのconsを生成してるだけなんだけど、それで膨大な、恐らくヒープを消費してニッチもサッチもいかなくなってくる、って事です。要するに巨大なガベージを生成してるに他なりません。
実は最初は、遅延評価で書けばどうなんだ、とか思って書いてたんですが、これもnが増大するととんでもない事になっていきます。
多分「定義のクールさ」って意味ではこの遅延評価版が一番カッコイイでしょう。見た目も綺麗ですし。マトモに定義通りに返してくれますし。
ところがさすがの遅延評価版でもnが100とかなると計算が終わりません。やはりどっかで大量のconsを扱うのが大変になるんですね〜。
さて、だったらメモ化はどうだ、って話になるんですが。
通常の高階関数のメモ化を利用して・・・ってのはこの場合は上手くないんです。
基本的に、n = 100を計算する時、n = 100の答えがあったらそいつをハッシュから持ってくる、ってのがメモ化の極意なんですが、生憎、フツーに実装したら今回のような「n = 100の状態を計算する為にはn = 99が必要」のケースだと上手く計算を省略してくれないんですよね。
理想的には再帰的にnを探ってくウチに得た値を利用して計算を行う、と言うちょっとした手動的な最適化が施されてないと、結局毎回新たな値を与える度にn=0まで到達してしまう。
今回のノイマンのモデルだと、どっちにせよnは順番に並んでますし、例えばn = 10を何の情報も無い状態で計算した際にn = 0〜10までのハッシュを全部記録して、n=11の計算の際にn=10「だけ」利用すれば11がすぐ得られる、と言う最適化を施しておいた方が良いわけです。
また、n=11まで計算した後で、n=15を計算するとn=12〜14までの情報は無いわけですが、ハッシュを手繰っていって、n=11の値が見つかった際にそこから計算をスタートしてn=12〜14までをハッシュに埋めつつn=15を返す、ってカタチにしておけば、0まで戻る無駄は省けるわけです。
今回はSRFI-69のハッシュテーブルを利用しています。
ローカル関数のgetはnが与えられた時、nに対応するvalueがハッシュ内にあるかどうか検索します。nが見つからなかった時にはn-1を検索、それでも見つからない場合は・・・と小さいキーを順次検索していって、valueが見つかった時、そのキーを返します。
ローカル関数putは逆に、あるキーからnに向けて計算した数値を逐次ハッシュに記録していって、キーがnと同じになった時にvalueを返して脱出します。
この2つのローカル関数で、ノイマンの定義を最適化するように試みてるんですが・・・・・・。
それでもやっぱn=100とかだと計算時間かかりすぎて、っつーかやっぱどうもヒープ食いつぶして上手い具合にいかないですねぇ。
ハッキリ言って、この問題は、「計算スピードの省略」じゃどうにもならなくって、どっちかっつーとメモリ容量との戦いの模様です。
なかなかconsは手強いですよ。
ズンドコキヨシ with Python
小ネタです。
何せ、3月初頭までパソコン壊れてたんで、知る機会が無かったんですよねぇ。残念。
さて、ちと問題を読み替えてみます。
単純に確率$p=0.5$で出る「ドコ」を成功、「ズン」を失敗として捉えると「ズンズンズンズンドコ」と言う文字列が出現する確率は
なお、問題の要請としては、例えば一回「失敗」が多い
の後でも「キ・ヨ・シ!」が出ても良い模様です。
つまり、この場合、文字列が要素「ズン」と「ドコ」の複合体と見た場合、5つ以上の長さの場合「キ・ヨ・シ!」を繋げる、そうじゃない場合はそのまま出力する、と言う問題として読み替える事が出来るのです。
ちなみに、こういう「失敗を何度か続けた後に成功する」と言う確率分布モデルがあって、それを幾何分布と言います。
 上の写真で言うと、Number of Failures until Success(成功するまでの失敗の数)が4以上の時に「キ・ヨ・シ!」を出力してそれより小さい場合は「キ・ヨ・シ!」を出力しなければ題意が満たせます。
さて、このロジックでプログラムを実装しますが、使用する言語はPython(2.7)、あとは幾何分布に従う確率変数を用いる為、Numpyを利用します。
一応、マイブームなんで、問題の要件とは若干違いますが、ジェネレータで実装しています(笑)。
次のようにして遊びます。
これがなかなか、目的の文字列が出ないんですよね(笑)。
ちなみに、フツーに実装しようが、今回みたいに幾何分布を利用して実装しようが結果は(理論的には)変わりません。
基本的に「ズンズンズンズンドコ キ・ヨ・シ!」が成立する確率は計算上、これ以上に「ズン」の部分が長い文字列の場合と合わせて、実は6.25%しかなく、反面、「ズン」の連続が4回に満たない文字列の出現確率は93.75%もあります。
つまり、このジェネレータを回しても10回に1回は出ない、って事なんですね。
クソ、面白いネタなんだけど、知らんかった(笑)。Javaの講義、試験が「自作関数を作り記述しなさい」って問題だったから— てくも (@kumiromilk) March 9, 2016
「ズン」「ドコ」のいずれかをランダムで出力し続けて「ズン」「ズン」「ズン」「ズン」「ドコ」の配列が出たら「キ・ヨ・シ!」って出力した後終了って関数作ったら満点で単位貰ってた
何せ、3月初頭までパソコン壊れてたんで、知る機会が無かったんですよねぇ。残念。
さて、ちと問題を読み替えてみます。
単純に確率$p=0.5$で出る「ドコ」を成功、「ズン」を失敗として捉えると「ズンズンズンズンドコ」と言う文字列が出現する確率は
失敗×失敗×失敗×失敗×成功 = 0.5×0.5×0.5×0.5×0.5 = 3.125%になります。そしてこの文字列が出現した「後」に「キ・ヨ・シ!」を繋げてやれば良い。
なお、問題の要請としては、例えば一回「失敗」が多い
ズンズンズンズンズンドコ
の後でも「キ・ヨ・シ!」が出ても良い模様です。
つまり、この場合、文字列が要素「ズン」と「ドコ」の複合体と見た場合、5つ以上の長さの場合「キ・ヨ・シ!」を繋げる、そうじゃない場合はそのまま出力する、と言う問題として読み替える事が出来るのです。
ちなみに、こういう「失敗を何度か続けた後に成功する」と言う確率分布モデルがあって、それを幾何分布と言います。
$\mathrm{Pr}\left( k\right) :=p\,{\left( 1−p\right) }^{k−1}$そうすると、要素数自体がこの幾何分布に従う確率変数となって、これで一気に文字列を生成する事が可能となります。

さて、このロジックでプログラムを実装しますが、使用する言語はPython(2.7)、あとは幾何分布に従う確率変数を用いる為、Numpyを利用します。
一応、マイブームなんで、問題の要件とは若干違いますが、ジェネレータで実装しています(笑)。
次のようにして遊びます。
これがなかなか、目的の文字列が出ないんですよね(笑)。
ちなみに、フツーに実装しようが、今回みたいに幾何分布を利用して実装しようが結果は(理論的には)変わりません。
基本的に「ズンズンズンズンドコ キ・ヨ・シ!」が成立する確率は計算上、これ以上に「ズン」の部分が長い文字列の場合と合わせて、実は6.25%しかなく、反面、「ズン」の連続が4回に満たない文字列の出現確率は93.75%もあります。
つまり、このジェネレータを回しても10回に1回は出ない、って事なんですね。
2015年7月17日金曜日
乱数を作ろう
最近のマイブーム
最近、SFCのすーぱーぷよぷよ通Remixにハマってます。今更ながら、ですが(笑)。
さて、これ遊びながら思ったんですが、あまりにもぷよの出現が偏りがあって、
「あんま良い乱数使ってないんじゃないの?」
とかぶつくさボヤいてたんですが(笑)。
しかし待てよ、と。どういう風に乱数プログラミングしてたんだろ?
※ もっとも、良い乱数使ったから、と言って、このテの落ち物パズルのゲーム性が上がる、とは限らないんですがね(笑)。
機械語には乱数は無い
ここんとこ、色々古いCPU、例えば6502とかZ80の資料を眺めていたんですが。
基本的には(当たり前かもしれないですが)機械語では「擬似乱数列」ってのは用意されてないんですね。
スーファミのCPUは65816と言うApple II GSで使用されていた、あまりメジャーじゃないCPUが使われています。
90年代初頭のスーファミの時代、ゲームプログラマはアセンブリ言語でプログラムする事が多かった模様です。そして当時は(ある程度は用意されてたみたいですが)開発ツールなんてのも今のようにゴージャスじゃなかった模様です。
と言う事は、かなりの確率で、例えばアクションゲームとかシューティングならさておき、RPG等、自作のアセンブリで書いた乱数ライブラリを使ってたりしたんじゃないでしょうか。そうじゃないと16bit CPU程度ではスピードはあんま稼げなかった筈なんですよね。
擬似乱数。果たしてどうやってプログラムするんでしょう。
SICPの乱数
話は唐突に飛びますが。
計算機プログラムの構造と解釈でも中途半端に(笑)、擬似乱数の作り方が載っています。
「ランダムに選ばれた」の意味は明瞭ではない. おそらく望んでいるのは randの次々の呼び出しは一様分布という統計の性質を持つ数列を生成することである. 適切な数列の発生法はここでは論じない. そうではなく, 手続きrand-updateがあり, ある数x1から出発し,
x2 = (rand-update x1)x3 = (rand-update x2)
を作ると, 値の列x1, x2, x3, ... は望みの統計的性質を持つと仮定する.
randをある固定した値random-initに初期化される局所状態変数xを持った手続きとして実装出来る. randを呼び出す度にxの現在値のrand-updateを計算し, これを乱数として返し, またそれをxの新しい値とする.
(define rand
  (let ((x random-init))
    (lambda ()
      (set! x (rand-update x))
      x)))
もちろん同じ乱数の列を単にrand-updateを直接呼び出すことで, 代入なしに生成することが出来る. しかしプログラムの乱数を使う部分は rand-updateに引数として渡すxの値をしっかり覚えていなければならないことを意味する.
そして注釈には次のような記述があります。
要するに具体的な例は全く紹介されてないんですね(笑)。
そこでWikipediaを頼ったコードは次のようなモノです。
これは線形合同法と言う極めて単純なやり方なんですが。ところが精度がメチャクチャ悪いんですね。
SICPではこの後、円周率πをモンテカルロ・シミュレーションで求めよう、ってトピックになるわけですが。
ところが、これやってみりゃ分かるんですが、円周率πに届かないんですよ(笑)。
さては、この結果知ってて「乱数作成」をサラーっと流したんじゃねぇの(笑)。
もう、SICP、こんなんばっかだよ(苦笑)。
実はSchemeって仕様には乱数が含まれてないんですね。
まあ、もちろん、各実装には実装依存で乱数生成プログラムが入ってるんでしょうが、あくまで「仕様としては」乱数は持ってません。
そう言う意味では結構メンドくせぇプログラミング言語なんですよね(笑)。
一方Lispはどうか、と言うと例えば、Common Lispなんかにはメルセンヌ・ツイスタのライブラリが公開されていて、共有されています。
Schemeは・・・・・・まあ、実装次第なんでしょうねぇ。Gaucheなんかはメルセンヌ・ツイスタを使ってたと思うんですが、他の実装だと保証の限りじゃないです。まあ、こう言う時、「ライブラリを共有しづらい」Schemeだとやりにくいですね(R7RSでだいぶ仕様上は改善されていますが)。
さて、Racketはどうでしょうか?
何だそりゃ。初めて聞きました。
実はCのソースコードが公開されていました。
これって結構シンプルじゃね?
さぁ、やっと本題です(笑)。
今回はこのMRG32k3aと言うアルゴリズムをRacketで「遅延評価を使って」実装してみたいと思います。SICPの遅延評価の乱数ストリームの仇をここで取ります(笑)。
Schemeでは仕様上、遅延評価に絡んだ機能はdelayとforceしか提供していません。
これだけだと甚だメンド臭く、「マトモに遅延評価をさせる」には、色々基本的な遅延評価用の手続きを実装しないといけません。事実、SICPの遅延評価の項目だとそこに結構な量が割かれているんですよね。
それじゃああんまりにもメンドくせえだろ、って言う貴方に朗報です(笑)。
実は分かりづらいんですが、SRFI-41ってのがあって、これを呼び出せば遅延評価の基本機構は使い放題、となります。
主なトコではstream-cons、stream-car、stream-cdr、stream-null、stream-map、stream-filter、stream-constant、stream-ref、stream-from等等等、SICP程度のお題ならこの程度で大体書けるようになってるライブラリです。
便利でこの辺考えなくって良いんで、これを使いましょう。
まずは大域変数をCコードに則って定義していきます。まあ、最終的にはこれらはletで局所変数化されるんですが、最初はまあ、Cのコードそのままで書いていきます。
さすがC、Lisp慣れしてると物凄くゴチャゴチャして見えますが(笑)。
原因の一つってのはここの箇所って実は「2つの事柄が1つにまとまってる」からなんですよね。
ここで行われてるのは次の2つです。
そしてp1を計算するComponent1なるプロシージャを設計すれば良い。オリジナルのCコードだと次の部分ですね。
ちなみに、最初、この2行目と3行目で何やってんだかサッパリ分かんなかったんですけど、何とこれ剰余計算やってるみたいです(笑)。え"え"え"え"え"、とか思ったんですが(苦笑)。うげぇ(笑)。
何で%使わねぇのかな。不思議です。ま、いいや(苦笑)。
つまり、この部分をSchemeで書くとこうなる、って事ですね。
stream1とComponent1を組み合わせると、例えば実行結果は次のようになります。
stream1の最初と2番目と3番目の値はSEEDの値、4番目、5番目の値はそれぞれ1番目と2番目、2番目と3番目の値を使って計算してるから同じ値、6番目からガラッと変わってきますね。
これはstream->listと言うプロシージャでアタマ10個分だけ「実体化」させたわけですが、これがずーっと「無限ストリーム」として続いていくわけです。
ただしComponent1とは使ってる引数の値と引数の順番が若干違うんで引っかからないように(笑)。
この辺をstream-mapを使って上手いこと実装します。
Combinationは新しいストリーム、ここでは乱数列を返します。
ちょっとまた、アタマ10個くらいstream->listで実体化させて見てみます。
おお、上手く動いてるようですね。
例えば乱数列の100番目、1000番目、10000番目はそれぞれ
となります。
おお、面白い(笑)。これで(基本的に)実装は完了です。
rand-updateを実装する通常のやり方は, a, b, mを適切に選んだ整数とし, mを法としてxをax + bで更新する規則を使うことである.
要するに具体的な例は全く紹介されてないんですね(笑)。
そこでWikipediaを頼ったコードは次のようなモノです。
これは線形合同法と言う極めて単純なやり方なんですが。ところが精度がメチャクチャ悪いんですね。
SICPではこの後、円周率πをモンテカルロ・シミュレーションで求めよう、ってトピックになるわけですが。
ところが、これやってみりゃ分かるんですが、円周率πに届かないんですよ(笑)。
さては、この結果知ってて「乱数作成」をサラーっと流したんじゃねぇの(笑)。
もう、SICP、こんなんばっかだよ(苦笑)。
Schemeと乱数
ところで。実はSchemeって仕様には乱数が含まれてないんですね。
まあ、もちろん、各実装には実装依存で乱数生成プログラムが入ってるんでしょうが、あくまで「仕様としては」乱数は持ってません。
そう言う意味では結構メンドくせぇプログラミング言語なんですよね(笑)。
最強の乱数生成法
統計処理言語Rやお馴染みのPythonではメルセンヌ・ツイスタと言われる乱数生成プログラムが組み込まれています。メルセンヌ・ツイスタは今のトコ、史上最強と言われる擬似乱数生成プログラムで、仕様がない言語で最強の乱数列が使い放題なんですよねぇ。一方Lispはどうか、と言うと例えば、Common Lispなんかにはメルセンヌ・ツイスタのライブラリが公開されていて、共有されています。
Schemeは・・・・・・まあ、実装次第なんでしょうねぇ。Gaucheなんかはメルセンヌ・ツイスタを使ってたと思うんですが、他の実装だと保証の限りじゃないです。まあ、こう言う時、「ライブラリを共有しづらい」Schemeだとやりにくいですね(R7RSでだいぶ仕様上は改善されていますが)。
さて、Racketはどうでしょうか?
Racketの乱数
残念ながらRacketの乱数はメルセンヌ・ツイスタではございません(笑)。RacketのDocumentationによると、L’Ecuyer’s MRG32k3a algorithmと言うアルゴリズムを用いてるそうです。何だそりゃ。初めて聞きました。
実はCのソースコードが公開されていました。
これって結構シンプルじゃね?
さぁ、やっと本題です(笑)。
今回はこのMRG32k3aと言うアルゴリズムをRacketで「遅延評価を使って」実装してみたいと思います。SICPの遅延評価の乱数ストリームの仇をここで取ります(笑)。
遅延評価の友
ところで。Schemeでは仕様上、遅延評価に絡んだ機能はdelayとforceしか提供していません。
これだけだと甚だメンド臭く、「マトモに遅延評価をさせる」には、色々基本的な遅延評価用の手続きを実装しないといけません。事実、SICPの遅延評価の項目だとそこに結構な量が割かれているんですよね。
それじゃああんまりにもメンドくせえだろ、って言う貴方に朗報です(笑)。
実は分かりづらいんですが、SRFI-41ってのがあって、これを呼び出せば遅延評価の基本機構は使い放題、となります。
主なトコではstream-cons、stream-car、stream-cdr、stream-null、stream-map、stream-filter、stream-constant、stream-ref、stream-from等等等、SICP程度のお題ならこの程度で大体書けるようになってるライブラリです。
便利でこの辺考えなくって良いんで、これを使いましょう。
※ 何故SRFI-41が「分かりづらい」かと言うと、遅延評価、つまりlazy-evaluationとして題名が付いてなくって「stream」と言う分かりづらい用語になってるからに他ならない。これは歴史的要因で、今ではlazy-evaluationと言う呼び方の方が妥当になってるが、過去にはそのままstreamと呼ばれてた事に由来する。
実装方針
最終的には単一のプロシージャにまとめますが、途中までは色々バラバラのパーツとして組み立てて行こうと思います。じゃないと遅延評価って良くわかりませんからね。大域変数
まずは大域変数をCコードに則って定義していきます。まあ、最終的にはこれらはletで局所変数化されるんですが、最初はまあ、Cのコードそのままで書いていきます。
この辺はまあ、いいですよね。乱数の種、SEEDも12345と言うフザけた(笑)値が与えられています。
ちなみに、実はm1、m2と言う2つの値は2の32乗から下2つの素数の模様です。
ちなみに、実はm1、m2と言う2つの値は2の32乗から下2つの素数の模様です。
Component
さて、Cソースのコメントで、取り敢えずComponent 1と書かれたところに着目してみます。さすがC、Lisp慣れしてると物凄くゴチャゴチャして見えますが(笑)。
原因の一つってのはここの箇所って実は「2つの事柄が1つにまとまってる」からなんですよね。
ここで行われてるのは次の2つです。
- p1 なる値の計算
- s10、s11、s12と言う3つの数の更新
当然Lisperとしては(笑)、「2つの計算目的は2つのプロシージャで書くべきだ」と言う原則を守ろうと思います。
さて、では手始めに2番から行きますか。
実はさっき定義しなかったんですが、原版ではs10、s11、s12と言う3つの値も大域変数として定義されています。
しかし「遅延評価を持ったLisp」であるSchemeではこれはやるべきじゃないトコなんですよね。
つまり、「各値を更新する」んじゃなくって、s10、s11、s12、そしてその後にはs13、s14・・・って「続いていくだろう」無限ストリームがある、って考えた方がスマートなわけです。
実際は、元のCコードを見ると、
(SEED SEED SEED p1 ....)
と言うようなカタチの無限ストリームを想定出来そうだ、って事ですよね。そしてp1以降は適当なプロシージャ、具体的には1の「計算によって」得られた数値がハマっていく。
そう言う想定から言うとまずは次のような「ストリーム生成」プロシージャをでっち上げられます。
そしてp1を計算するComponent1なるプロシージャを設計すれば良い。オリジナルのCコードだと次の部分ですね。
ちなみに、最初、この2行目と3行目で何やってんだかサッパリ分かんなかったんですけど、何とこれ剰余計算やってるみたいです(笑)。え"え"え"え"え"、とか思ったんですが(苦笑)。うげぇ(笑)。
何で%使わねぇのかな。不思議です。ま、いいや(苦笑)。
つまり、この部分をSchemeで書くとこうなる、って事ですね。
stream1とComponent1を組み合わせると、例えば実行結果は次のようになります。
stream1の最初と2番目と3番目の値はSEEDの値、4番目、5番目の値はそれぞれ1番目と2番目、2番目と3番目の値を使って計算してるから同じ値、6番目からガラッと変わってきますね。
これはstream->listと言うプロシージャでアタマ10個分だけ「実体化」させたわけですが、これがずーっと「無限ストリーム」として続いていくわけです。
Component2
基本ロジックはComponent1と全く同じなんでサクッと書いていきます。ただしComponent1とは使ってる引数の値と引数の順番が若干違うんで引っかからないように(笑)。
Combination
現時点ストリームが2つあります。p1、p2はそれぞれのストリームの4番目からスタートして、条件に従ってどっちかを選択してちょこちょこと計算して新しいストリームに組み込まれるわけです。この辺をstream-mapを使って上手いこと実装します。
Combinationは新しいストリーム、ここでは乱数列を返します。
ちょっとまた、アタマ10個くらいstream->listで実体化させて見てみます。
おお、上手く動いてるようですね。
例えば乱数列の100番目、1000番目、10000番目はそれぞれ
となります。
おお、面白い(笑)。これで(基本的に)実装は完了です。
ソースコード
最後に各パーツを局所手続き化して全コードをまとめます。2015年2月26日木曜日
言語処理系とは: 補題
うーん、昨日やってた簡単なインタプリタ/コンパイラ作成ですが、気になってた再帰部分を末尾再帰に書き換えられるのか、ってやってみたんですが、上手く行かなかったですね。
継続受け渡しで書き換えると形式的には末尾再帰になるんですが、最適化はされなさそうです。
あと、コンパイラのコードもちょっとムダな部分があったんで、より関数プログラミングっぽく書きなおしてみました。
さて、lexと格闘、です。
継続受け渡しで書き換えると形式的には末尾再帰になるんですが、最適化はされなさそうです。
あと、コンパイラのコードもちょっとムダな部分があったんで、より関数プログラミングっぽく書きなおしてみました。
さて、lexと格闘、です。
2015年2月25日水曜日
言語処理系とは
さて、ここ数日、ハードウェアの動作を勉強しようと思って、このページを参考にしててちょこちょこプログラムをSchemeで書く為に格闘してました。
いやぁ、なかなかC言語を読むのが難しくて手こずってたんですが、ある程度カタチになったんで、メモ代わりに。
しっかし、Cのプログラム見てると、大域変数使いまくりで、破壊的変更ありーの、ポインタなんて出てきた日にゃあ何やってんだか一発で分からんし、ホント困ったもんですよ。
例によって、関数プログラミング的に解題していきたいと思います。
はい、左様でやんすね。
まず、元々はその、字句解析と構文解析をどうやるんだ、ってのの疑問からスタートしたわけですが。
まあ、続けてやっていきましょうか。
良く分からんC言語の関数で、調べてみると次のような事が書いてある。
あっれぇ、Schemeには
そんな時にSagittarius Schemeの作者の人から助け舟が。
あ、そう、こういう時
仕様書見ても良く分かんなかったもんな~。
まあ、要するにこういう事らしいです。ストリームに例えば、"1 2 3 4 5"ってあった場合、
まあ、敢えて言うと、こういう入出力系ってインタプリタで試しづらいんですよね。
インタプリタ上のReaderで
一方、
これさえ分かればCのソースをSchemeで書きなおすのは簡単です。
Scheme版では、exprParser.hで大域変数として定義されてた
Scheme版
"12 + 3 - 4"と言う入力を分解して、要素が数値の場合は
こういうテストがC言語だとやりづらいトコロです(
さて、ここでまた悩んだんですよね~。Schemeでも
大体、構造体絡むと破壊的変更が避けられなくなったりするんですよねぇ。しかもCのコード見ると、何だか循環参照のように見えるし・・・(実は違うそうですが)。
結局、わざわざ構造体で構文木を定義するのは止めました。これはリストを持たない貧弱なCだから必要なんであって、SchemeなんかのLisp系言語では必要ない。要するに直接構文木(らしきもの)をリストを使って直接生成してやれば良い、って事です。
つまり、例えば上のような
と言うトークン列に対して
オリジナルのコードだと、大域変数が
また、オリジナル版だと、破壊的変更前提の無引数の手続きなんですが、Scheme版だと、やっぱり
では、動作を見てみます。
さっきの設計と真逆になってるように見えますが、これで良いのです。そもそも、連想リストだと順序には意味がありません。
基本的な構文構造を表現する連想リスト(構文木リスト = AST)は
となっていて、valは数値の時にしか生成されず、また、leftやrightの中も再帰的にASTが収まっていきます。
構造はほぼオリジナルのコードと同じです。特に手を加えてはいません。
しっかし、ひっさしぶりに末尾再帰じゃない再帰コード書いたんで気持ち悪いですね(笑)。オリジナルのC版も、これじゃあ大して効率良く無いんじゃないでしょうか。あー、そうか、コンパイラ書く為の前フリか(笑)。
キチンと計算されてますね。
うーん、正直、なんで
なんてのがあるんだか分からないですね。これねぇ方が動くんだけど・・・。
まあいいや、上記のコード部分を除いてSchemeで書いた
さっき書いたテストまんまそのまんまですね。
では動作確認です。
完璧ですね。
ではScheme版インタプリタのソースコード全容を。
では、次はいよいよコンパイラ、です。
この辺の定義もSchemeには要らないですね。シンボルとリストで凌ぎましょう。
一つは構文木を受け取って、上のロジックに従って命令のリストを生成する
ちなみに、
では動作テストです。
見て分かる通り、"12 + 3 - 4"と言う入力が、opcodeとoperandと言う2つのキーを持つ、連想リストを5要素としたベクタ(配列)に変換されています。ベクタの番号0~4は結果、実行順序を表してる事になりますね。
Cで書いてきたのにCで出力する、なんつーのはバカっぽいな、とか思ったんですが(笑)、郷に入りては郷に従え、でSchemeで書いてきたのにSchemeで出力します(爆)。
ちなみに、最初は、オリジナルのコードに従って書いてたんですが、上手く動いたのをきっかけにしてもうちょっと欲が出てきたんですね。
元のコードにはいくつかちょっと特徴があります。
コンパイラの全ソースコードは次のようなものです。
ちょっと暫くこの辺のネタで遊んでみますかね。
いやぁ、なかなかC言語を読むのが難しくて手こずってたんですが、ある程度カタチになったんで、メモ代わりに。
しっかし、Cのプログラム見てると、大域変数使いまくりで、破壊的変更ありーの、ポインタなんて出てきた日にゃあ何やってんだか一発で分からんし、ホント困ったもんですよ。
例によって、関数プログラミング的に解題していきたいと思います。
インタプリタとコンパイラ
言語処理系とは、プログラミング言語で記述されたプログラムを計算機上で実 行するためのソフトウエアである。そのための構成として、大別して2つの構 成方法がある。
元のプログラムをソースプログラム、 翻訳の結果と得られるプログラムをオブジェクトプログラムと呼ぶ。 機械語で直接、計算機上で実行できるプログラム を実行プログラムと呼ぶ。オブジェクトプログラムがアセンブリプログラムの 場合には、アセンブラにより機械語に翻訳されて、実行プログラムを得る。他 の言語の場合には、オブジェクトプログラムの言語のコンパイラでコンパイル することにより、実行プログラムが得られる。仮想マシンコードの場合には、 オブジェクトコードはその仮想マシンにより、インタプリトされて実行される。
- インタープリター(interpreter,翻訳系): 言語の意味を解析しながら、その意味する動作を実行する。
- コンパイラ(compiler,通訳系): 言語を他の言語に変換し、その言語の プログラムを計算機上で実行させるもの。狭い意味でコンパイラは、言語を機 械語に変換し、実行するものであるが、他の言語、あるいは仮想機械コードに 変換するものもコンパイラと呼ぶ。他の言語に変換するときには、特に translatorと呼ぶ場合もある。
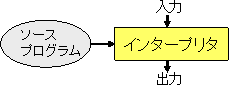
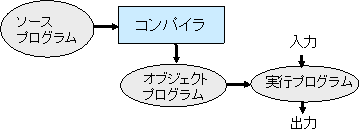
はい、左様でやんすね。
言語処理系の基本構成
コンパイラにしてもインタプリターにしても、その構成は多くの共通部分を持 つ。すなわち、ソースプログラムの言語の意味を解釈する部分は共通である。 インタプリターは、解釈した意味の動作をその場で実行するのに対し、コンパ イラではその意味の動作を行うコードを出力する。
言語処理系は、大きく分けて、次のような部分からなる。
- 字句解析(lexical analysis): 文字列を言語の要素(トークン、token)の列に分解する。
- 構文解析(syntax analysis): token列を意味を反映した構造に変換。こ の構造は、しばしば、木構造で表現されるので、抽象構文木(abstract syntax tree)と呼ばれる。ここまでの言語を認識する部分を言語のparserと 呼ぶ。
- 意味解析(semantics analysis): 構文木の意味を解析する。インタプリ ターでは、ここで意味を解析し、それに対応した動作を行う。コンパイラでは、 この段階で内部的なコード、中間コードに変換する。
- 最適化(code optimization): 中間コードを変形して、効率のよいプログ ラムに変換する。
- コード生成(code generation): 内部コードをオブジェクトプログラムの 言語に変換し、出力する。例えば、ここで、中間コードよりターゲットの計算 機のアセンブリ言語に変換する。
コンパイラの性能とは、如何に効率のよいオブジェクトコードを出力できるか であり、最適化でどのような変換ができるかによる。インタープリタでは、プ ログラムを実行するたびに、字句解析、構文解析を行うために、実行速度はコ ンパイラの方が高速である。もちろん、機械語に翻訳するコンパイラの場合に は直接機械語で実行されるために高速であるが、コンパイラでは中間コードで やるべき操作の全体を解析することができるため、高速化が可能である。
また、中間言語として、都合のよい中間コードを用いると、いろいろな言語か ら中間言語への変換プログラムを作ることで、それぞれの言語に対応したコン パイラを作ることができる。
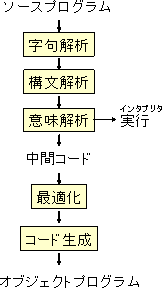
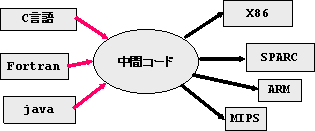
まず、元々はその、字句解析と構文解析をどうやるんだ、ってのの疑問からスタートしたわけですが。
まあ、続けてやっていきましょうか。
例題: 式の評価
さて、例として最も簡単な数式の評価について、インタプリターとコンパイラ を作ってみることにする。目的は,とまあ、ここでCで書かれたソースが示されるんですが、色々やってみた結果、こういうヘッダファイルで定義される
の式の入力に対し、この式を計算し、12 + 3 - 4
と出力するプログラムを作ることである。これは、式という「プログラミング 言語」を処理する言語処理系である。「式」という言語では、tokenとして、 数字と"+"や"-"といった演算子がある。11
まずは、字句解析ではこれらのトークンを認識する。例えば、上の例では、
12の数字、+の演算子、3の数字、-の演算子、4の数字、終わりという列に変換する。
tokenは、tokenの種類と12の数字という場合の12の値の2つの組で表される。 以下にtokenの種類を定義するexprParser.hを示す。
#define マクロなんかはSchemeじゃ要らねぇな、ってのが分かりました。最初はCコードに則ってやってこう、って思ったんですが、どうも具合が良くないんでオミットです。何せ、Lisp系言語だとシンボルがそのまま使えるんでこういう「Cっぽい」定義は要らないですね。字句解析を行う関数getTokenを示す。さあて、これがまず最初凄くツマッてたトコなんですよね~。まず、
ungetcって何だ?とか思って(笑)。良く分からんC言語の関数で、調べてみると次のような事が書いてある。
読み込んだ文字を1文字押し戻すとは、どういう事なんだ?というわけですが、うそぉん、ストリームから取ってきた文字をまたストリームに戻せるんかい、とか思って(笑)。さすがC言語(苦笑)。
戻すには ungetc()を使用します。
読み込んだ文字とは、、ファイル読み込みや、キーボードからの入力などの
ストリームと呼ばれるものから読み込んだ文字です。
その文字を、fgetc()や、getchar()などで読み込んだ後、
またもう1度ストリームに戻してしまう、というのが ungetc()の処理です。
あっれぇ、Schemeには
read-charに対してunread-charなんてあっただろうか、と困ってたわけですね(笑)。当然無いですがね(苦笑)。そんな時にSagittarius Schemeの作者の人から助け舟が。
@cametan_001 peek-charで足りないんですか?
— Kei (@tk_riple) February 23, 2015
あ、そう、こういう時
peek-charを使うんだ、って今回初めて知った次第です(笑)。ダメじゃん(笑)。仕様書見ても良く分かんなかったもんな~。
わりぃ、ホンマ、何言ってるんだかサッパリ分からん(苦笑)。[[手続き]] (peek-char) [[手続き]] (peek-char port)入力ポートportから取り出すことができる次の文字を返すが、次の文字を指し示す様なポートの更新は行なわれない(ポート内の位置は変わらない)。取り出す文字が存在しなかった場合はファイル終りオブジェクトが返される。port引数は省略でき、その場合のデフォルトはcurrent-input-portが返す値である。
注:peek-charの呼び出しで返される値は、同じポートに対するread-charの呼び出しで返される値と同じものである。唯一の違いは、ポートに対する直後のread-char呼び出しもしくはpeek-char呼び出しで、直前のpeek-char呼び出しで返された値が返されるという点である。特に対話型ポートに対してpeek-charを呼び出した場合、入力を待ち続けてread-charがハングする時には、peek-charも必ずハングすることになる。
まあ、要するにこういう事らしいです。ストリームに例えば、"1 2 3 4 5"ってあった場合、
read-charは"1"を取ってきたあとストリームを"2 3 4 5"に更新するけど、peek-charの場合は"1 2 3 4 5"から"1"を取ってもストリームを"1 2 3 4 5"のままに置いておくそうです。まあ、敢えて言うと、こういう入出力系ってインタプリタで試しづらいんですよね。
read-charだとまだいいんですが、peek-charだと無限ループみたいな事になって、何だか良く分からん事になります。インタプリタ上のReaderで
'hogeと入力すると、ストリームに'hogeが入って、次からread-charを呼び出すと、ストリームに残ってた文字が一字づつ出力されていきます。一方、
peek-charの場合、ポートが更新されないんで永遠に一文字目の#\'がずーっと出力され続けますね。これを解除するにはもう一度read-charを呼んでポートを更新しないといけません。これさえ分かればCのソースをSchemeで書きなおすのは簡単です。
Scheme版では、exprParser.hで大域変数として定義されてた
tokenValとcurrentTokenの2つをgetTokenプロシージャ内部から多値で返すようにしています。わざわざ大域変数として定義して破壊的に変更するのも嫌ですしね。この関数は、字句を読み込み、currentTokenにtokenの種類、NUMの場合に tokenValに値を返す。だから、Scheme版は本当に値を返してますが、オリジナルのCコードは返してませんね。大域変数を書き換えてるわけで、副作用目的の、要するに「手続き」がこのC版
getTokenの正体です。大体、関数の型がvoidですしね。Scheme版
getTokenの動作は次のようになります。"12 + 3 - 4"と言う入力を分解して、要素が数値の場合は
tokenValとしてその値を返し(数値じゃない場合は0)、それとそのtokenValの「情報」をcurrentTokenとして返します。こういうテストがC言語だとやりづらいトコロです(
main関数が無い状態だとどう動作してるんだか分かったモンじゃないし、要コンパイルなのが自明です)。BNFと構文木
では、この「式」というプログラミング言語の構文とはどのようなものであろうか。例えば、次のような規則が構文である。
このような記述を、BNF (Backus Naur Form または Buckus Normal Form) という。
このような構造を反映するデータ構造を作るのが、構文解析である。図に示す。
構文解析のデータ構造は、以下のような構造体を作る。これをexprParser.hに 定義しておく。
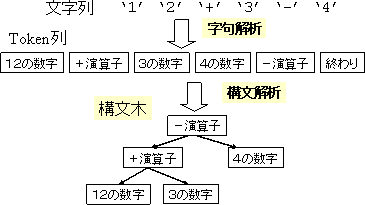
さて、ここでまた悩んだんですよね~。Schemeでも
record-typeを使って構造体で作るべきか?大体、構造体絡むと破壊的変更が避けられなくなったりするんですよねぇ。しかもCのコード見ると、何だか循環参照のように見えるし・・・(実は違うそうですが)。
結局、わざわざ構造体で構文木を定義するのは止めました。これはリストを持たない貧弱なCだから必要なんであって、SchemeなんかのLisp系言語では必要ない。要するに直接構文木(らしきもの)をリストを使って直接生成してやれば良い、って事です。
つまり、例えば上のような
[12の数字] [+演算子] [3の数字] [4の数字] [-演算子] [終わり]
と言うトークン列に対して
'([-演算子] ([+演算子] [12の数字] [3の数字]) [4の数字])
みたいなリストを生成して返してやれば良い、って事です。しかも、連想リストを生成するようにしてみます。
この構文木を作るプログラムが、readExpr.cである。 このプログラムでは、exprParser.hで定義されて いるASTを使って、構文木を作っている。このデータ構造は 式の場合は、演算子とその左辺の式と右辺の式を持つ。数字の場合はこれらを 使わずに値のみを格納する。tokenを読むたびに、データ構造を作っている。ASTは定義しない事にしましたが、tokenを読むたびにデータ構造を作り出して、構文木のデータ構造を作って返すのはLispではお手の物です。次が等価のScheme版
readExprです。オリジナルのコードだと、大域変数が
getToken呼び出す度に書き換えられてて、その破壊的変更をアテにするプログラミングな為、これを関数プログラミングで再現するにはどうすりゃエエんだ、ってんで結構悩んだんですよねぇ。本当だったらもっと綺麗に書けたんじゃねぇの、って若干心残りがあるんですが、一応オリジナルのロジックを出来るだけ尊重するようにはしてみました。また、オリジナル版だと、破壊的変更前提の無引数の手続きなんですが、Scheme版だと、やっぱり
tokenValとcurrentTokenを受け取るプロシージャにしています。では、動作を見てみます。
さっきの設計と真逆になってるように見えますが、これで良いのです。そもそも、連想リストだと順序には意味がありません。
基本的な構文構造を表現する連想リスト(構文木リスト = AST)は
'((op . currentToken) (val . tokenVal) (left . 左の枝) (right . 右の枝))
となっていて、valは数値の時にしか生成されず、また、leftやrightの中も再帰的にASTが収まっていきます。
解釈実行: インタプリター
この構文木を解釈して実行する、すなわちインタプリターをつくってみること にする。その動作は、まあ、今までも何度かインタプリタは書いてきましたが、構文木を使って、ってのは初めてですね。
このプログラムがevalExpr.cである。 evalExpr.cは、構文木ASTを解釈して、解釈する。
- 式が数字であれば、その数字を返す。
- 式が演算子を持つ演算式であれば、左辺と右辺を解釈実行した結果を、 演算子の演算を行い、その値を返す。
これらは再帰的に呼び出しが行われていることに注意しよう。
- 数字のASTつまり、opがNUMであれば、その値を返す。
- 演算式であれば、左辺を評価した値と右辺を評価した値をopに格納さ れている演算子にしたがって、計算を行う。
構造はほぼオリジナルのコードと同じです。特に手を加えてはいません。
しっかし、ひっさしぶりに末尾再帰じゃない再帰コード書いたんで気持ち悪いですね(笑)。オリジナルのC版も、これじゃあ大して効率良く無いんじゃないでしょうか。あー、そうか、コンパイラ書く為の前フリか(笑)。
evalExprの動作テストは以下の通り。キチンと計算されてますね。
mainプログラムでは、関数readExprを呼び、構文木を作り、それを関数 evalExprで解釈実行して、その結果を出力する。これが、インタプリターであ る。先のプログラムと大きく違うのは、式の意味を表す構文木が内部に生成さ れていることである。この構文木の意味を解釈するのがインタプリターである。 (readExprでは1つだけ先読みが必要であるので、getTokenを呼び出している)
うーん、正直、なんで
if(currentToken != EOL){
 printf("error: EOL expected\n");
 exit(1);
    }
なんてのがあるんだか分からないですね。これねぇ方が動くんだけど・・・。
まあいいや、上記のコード部分を除いてSchemeで書いた
mainプロシージャが次になります。さっき書いたテストまんまそのまんまですね。
では動作確認です。
完璧ですね。
ではScheme版インタプリタのソースコード全容を。
では、次はいよいよコンパイラ、です。
コンパイラとは
次にコンパイラをつくってみる。コンパイラとは、解釈実行する代わりに、実 行すべきコード列に変換するプログラムである。実行すべきコード列は、通常、 アセンブリ言語(機械語)であるが、そのほかのコードでもよい。中間コード として、スタックマシンのコードを仮定することにする。スタックマシンは以 下のコードを持つことにする。
- PUSH n : 数字nをスタックにpushする。
- ADD : スタックの上2つの値をpopし、それらを加算した結果をpushする。
- SUB : スタックの上2つの値をpopし、減算を行い、pushする。
- PRINT: スタックの値をpopし、出力する。
コンパイラは、このスタックマシンのコードを使って、式を実行するコード列 を作る。例えば、図で示した例の式12+3-4は下のようなコードになる。
スタックマシンでの実行は以下のように行われる。
stackCode.hには、コードとその列を格納する領域を定義してある。
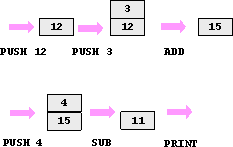
この辺の定義もSchemeには要らないですね。シンボルとリストで凌ぎましょう。
コンパイルの手順は、以下のようになる。さて、
この中間コードを生成するのが、compileExpr.cである。構文木を入力して、 再帰的に上のアルゴリズムを実行する。コードはCodesという配列に格納して おく。
- 式が数字であれば、その数字をpushするコードを出す。
- 式が演算であれば、左辺と右辺をコンパイルし、それぞれの結果をスタッ クにつむコードを出す。その後、演算子に対応したスタックマシンのコードを 出す。
- 式のコンパイルしたら、PRINTのコードを出しておく。
compileExprですが、Scheme版では2つに分けました。一つは構文木を受け取って、上のロジックに従って命令のリストを生成する
Codes、もう一つは構文木を受け取ってCodesを呼び出し、結果のリストを反転させた後、vector(Cで言う配列にあたる)に変換するcompileExprです。ちなみに、
Codesが全体的に生成するのは、見た目は連想リストですが、連想リストではありません。と言うのも、今回生成するのはアセンブリ的なリストなんで「順序が重要」だからです。連想リストはハッシュ的に順序は重要じゃないんで、リストとして順序を保持したままベクタへ変換する必要性があるから、です(ただし、要素は連想リストです)。では動作テストです。
見て分かる通り、"12 + 3 - 4"と言う入力が、opcodeとoperandと言う2つのキーを持つ、連想リストを5要素としたベクタ(配列)に変換されています。ベクタの番号0~4は結果、実行順序を表してる事になりますね。
コード生成では、ここではスタックマシンのコードをCに直して出力すること にしよう。Cで実行させるために、mainにいれておくことにする。このプログ ラムが、codeGen.cである。
Cで書いてきたのにCで出力する、なんつーのはバカっぽいな、とか思ったんですが(笑)、郷に入りては郷に従え、でSchemeで書いてきたのにSchemeで出力します(爆)。
ちなみに、最初は、オリジナルのコードに従って書いてたんですが、上手く動いたのをきっかけにしてもうちょっと欲が出てきたんですね。
元のコードにはいくつかちょっと特徴があります。
- スタックマシンが別にあるわけじゃなくって、スタックマシン自体も毎回コンパイルで生成してる。
- printfが多用されているが、結果的にCコードである「文字列」を生成してるだけである。従って本来なら、Cコードを生成する文字列をでっち上げるのが実は大半の本質的作業である。
つまり、SchemeでSchemeコードを生成するにせよ
- スタックマシン自体を毎回生成してるようなコードを吐いて構わない。
- 結局文字列を生成、加工するだけで良い
と言う2点が極めて重要なんです。それでスタックマシン用のコードをSchemeのコードとして変換出来るわけです。
それで、もう一つあって、最初はSchemeコードを生成する際、これは大方、破壊的変更を多用した「いわゆる」スタックマシンをSchemeで書いてるように生成すれば良いのかな、って思ってたんですが、生成されるコードも関数プログラミング様式で生成出来ないか、って思い直したわけです。
初め、それは大変なんじゃないか、って思ってたんですが、出力を噛まさずに文字列だけで操作するなら、むしろ再帰と相性が良い、ってのが分かったんですね。
っつーか、Lispなんかの関数プログラミングだと、プログラミングやってる側だと書くのも読むのも大変になるネストの深さになるわけですが、そこはコンパイラ、全く人間の「可読性」関係無く文字列操れるじゃん、ってぇんで書いてみたのが次のコードになります。
ちょっとどういうSchemeコードを生成するのか、見てみましょうか。
最後の
前半の部分は言わばテンプレで、毎回
実際に
と言う入力が、
ぶっちゃけ、人としてはあまり書きたくないスタイルですが(笑)、コンパイラなら別にへっちゃらで言われた通りに変換していってくれて、実はコード生成は、再帰を使う限り、こっちの方が(この例だと)簡単なんじゃないか、ってカンジです。
そう、
例えば、実験として、次のような式を入力してもガンガン「関数型」のコードに変換してくれます。
すげぇバカバカしいんですが、面白いです(笑)。なかなか構文解析とかコンパイラ書くのって面白いな、って感動しました。最後の
(codeGen code)ってのでSchemeコードを生成するわけですね。前半の部分は言わばテンプレで、毎回
codeGenが呼び出される度に「スタックマシン」を生成します。実際に
codeGenが毎回生成してるのがmainプロシージャの部分で、結果、"12 + 3 - 4"
と言う入力が、
に書き換えられてて、これはホント、そのまま関数プログラミングでのスタイルです。空リストをスタックに見立てて、内側のプロシージャは外側へと結果を返して、外側のプロシージャはそれを引数として受け取って・・・って連鎖してるわけですね。
(define (main)
  (sub
    (push 4
      (add
        (push 3
          (push 12
'()))))))
ぶっちゃけ、人としてはあまり書きたくないスタイルですが(笑)、コンパイラなら別にへっちゃらで言われた通りに変換していってくれて、実はコード生成は、再帰を使う限り、こっちの方が(この例だと)簡単なんじゃないか、ってカンジです。
コンパイラのmainプログラムであるが、readExprまではインタープリタと同じ である。標準出力に出力されるプログラムに適当に名前をつけ(たとえば、 output.c)これをCコンパイラでコンパイルして実行すればよい。(assembler のファイルの場合はasコマンドでコンパイルする。)
そう、
displayせずにファイルに書き出せば、要するにコンパイラとして機能する、って事です。これは面白い。例えば、実験として、次のような式を入力してもガンガン「関数型」のコードに変換してくれます。
コンパイラの全ソースコードは次のようなものです。
ちょっと暫くこの辺のネタで遊んでみますかね。
2015年2月17日火曜日
Schemeでスタックマシンの基礎
Wizardryってゲームが好きです。
まあ、あまりにも有名なゲームなんで知らない人は多分いないと思うんですが、一応ちょっと解説してみますか。
世界で初めて、商用として成功したRPG(ロールプレイングゲーム)ですね。
さて、そのUCSD Pascal。Wikipediaではこんな記述が成されていますね。
かっちょいい(笑)!仮想マシンですよ、仮想マシン(笑)。
問題は仮想マシンってのは実装が簡単なんですかねぇ。次のような記述が続きます。
Wikipediaのスタックマシンの項目読んでてもイマイチピンと来ない。 やっぱ一回実装してみるに限りますね。
元々、CPUの動作とかは全く知らない門外漢なんですが、そろそろその辺勉強しても良い頃かもしれません。
ってなわけで、ネットで検索するとJavaで書かれた「仮想計算機を作ろう」と言うページを見つけたんで、Java書けないんですが(笑)、何とか読み下して、Schemeで簡単なスタックマシンを実装してみたいと思います。
はいはい。
次へ進んでみましょうか。
では今回のソースです。
まあ、あまりにも有名なゲームなんで知らない人は多分いないと思うんですが、一応ちょっと解説してみますか。
世界で初めて、商用として成功したRPG(ロールプレイングゲーム)ですね。
注: 良く「世界初のRPG」って記述が成されますが、これは嘘です。実は世界初のRPGはPLATOと言うメインフレームのプラットフォームで作られていて、それは1974年頃の事でした。WizardryはそのPLATOで1977年頃に作られたMMORPG(ビックリするかもしれないけど、ネット時代より遥か以前にMMORPGは既に存在していた!)であるOublietteと言うゲームをApple II上で1人でプレイできるように「改良した」もの、って言って良いです。さて、このWizardryってのは色々なマシンに移植されてるわけですが。ファミコンみたいなゲーム専用機以外でもザーッと挙げてみると、
- Apple II
- Apple Macintosh
- SHARP MZ-2500
- SHARP X1/Turbo
- 富士通 FM-7
- 富士通 FM-77
- NEC PC-8801
- NEC PC-9801
- MSX-2
- Commodore 64
- Commodore 128
- IBM-PC
と物凄い数の移植なんですね。
これだと物凄い数のプログラマが物凄く苦労して移植したんじゃないか、って思うでしょう。ところが、メインプログラマのロバート・ウッドヘッド氏の話によると、
「殆ど(80%くらい?)ソースコードは同じなんだ。違うのは画像出力とか、機械によって差があるところだけだね。」
との事です。
当時のゲームプログラムだとBASIC、あるいはスピードが欲しい場合は直接アセンブリでコーディングするのが普通だったらしいんですが、Wizardryの設計の優れたところ、と言うのは、Pascalを使った構造化プログラミングで作ったほぼ最初の商用製品だ、と言うトコロでしょう。完全にシナリオデータとゲーム本体のプログラムを分けているらしく、外国語へのポーティングも必要最小限の労力で行えるように設計されているらしく、恐らく凄く綺麗な「教科書的な」プログラミングの塊なんじゃないでしょうか。
ここで使われたPascal処理系をUCSD Pascalと言います。これは仮想マシン上で動くように設計されたPascal処理系の代表格で、まさに当時の"Write Once, Run Anywhere"を実現してたようですね・・・そう、当時はJava的な存在だったわけです。
注: C言語も「マシン間の差異があってもソースの移植性を極力大事にする」意図で設計されていますが、随分と違うアプローチで、元々Pascalは「仮想マシンを前提として動かす」と言うアプローチになってました。しかも、C言語は原則的に16bit機以上が対象で、黎明期の8bitのパーソナルコンピュータ上だと「動かしづらい」プログラミング言語だった模様です。その辺、当時の環境だとPascalの方がメリットが大きかったのでしょう。
さて、そのUCSD Pascal。Wikipediaではこんな記述が成されていますね。
CPUの異なるパーソナルコンピュータ上で動作するために、P-Machineと呼ばれる仮想マシンを使用する。コンパイラはプログラムをそれぞれのCPU用の機械語に翻訳するのではなく、P-Machineの機械語であるP-Codeに翻訳する。そのため、P-Codeの仮想マシンを実装すればどのようなパーソナルコンピュータ上でも実行可能であった。
かっちょいい(笑)!仮想マシンですよ、仮想マシン(笑)。
問題は仮想マシンってのは実装が簡単なんですかねぇ。次のような記述が続きます。
P-Machineは典型的なスタックマシンで、様々な処理を主にスタック上で行うアーキテクチャを持っていた。スタックマシン・・・何じゃそれ、なんですが(笑)。
Wikipediaのスタックマシンの項目読んでてもイマイチピンと来ない。 やっぱ一回実装してみるに限りますね。
元々、CPUの動作とかは全く知らない門外漢なんですが、そろそろその辺勉強しても良い頃かもしれません。
ってなわけで、ネットで検索するとJavaで書かれた「仮想計算機を作ろう」と言うページを見つけたんで、Java書けないんですが(笑)、何とか読み下して、Schemeで簡単なスタックマシンを実装してみたいと思います。
スタックとは何か?
知るか(笑)。
いや、昔勉強した事あった、って言えばあったんですが、「一体何の為にこれやってんのか」ってのがサッパリ分からないんで、すっかり忘れてます(笑)。Lisp系だと何でもリストを使えば済む、ってんであんまマジメに考えてなかったんですよねぇ。改めて勉強です。
仮想スタックマシンを実装するに当たって、スタックというデータ構造について理解している必要がありますから、まずはこれについて、簡単なプログラムを交えながら解説することにします。
はいはい。
スタックはデータ構造の1つで、LIFO(Last In First Out)という性質を持っています。これは、最後に入れたデータを最初に取り出すことができるという意味になります。何か、んな事言ってたなぁ。
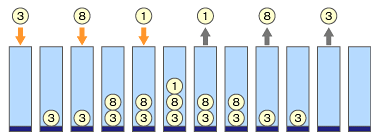
ボール(値)を上からしか出し入れできない、不透明な長い箱をイメージするとよいでしょう。このような箱からボールを取り出すには、最後に入れたボール(値)からしか取り出せないということになります。
値をスタックへ格納する操作はpushと呼ばれ、値をスタックから取り出す操作はpopと呼ばれます。この2つの基本操作でスタックへ格納するデータをコントロールできます。オレンジ矢印が値を積むpushの操作を表し、グレイ矢印が値を取り出すpopの操作を表しています。次に取り出せるデータを参照するためのpeekという操作が提供されることもあります。
スタックにはどのような値がどういう順番で格納されているのかについては隠ぺいされていて、スタックを使用するプログラムからは見えないという点も重要です。
このように、スタックでは単純な操作しかできないのですが、後置記法と組み合わせることにより結構複雑な計算を実現できます。基本動作を理解するために、スタックの使い方と簡単な実装方法について見てみましょう。なるほど、です。
次へ進んでみましょうか。
スタックを実装してみる
まずは、その
問題は
が、そうすると困ったことになるんですね。原則、
こう言う場合多値を用いて両者とも返しちゃう、ってのが一番Schemeらしいでしょう。そう言う実装方針で上のコードは掻きました。

一方、所詮動作確認なんで、あんま面倒臭い事考えたくないんで、適当にベタ書きしてみます。
オリジナルのJavaコードに対応させようとすると、大体こんなカンジですかね。Javaなんかは由緒正しい「逐次処理言語」なんで、コードがフラットなんですが、Schemeの場合、特に今回は
ポイントは
では動作確認してみましょうか。
元ページのJavaコードの実行結果と同じになっていますね。確かにLIFOになっています。
さいでっか。じゃあ、次行きましょうか。
まんまやん、まんま、そのまんまです。
では
これをこのまま実装すると次のようになります。
先ほど書いた通り、
例として、次の3つのファイルを用意しておきます。

はい、確かになっていますね。
pushとpopを実装してみます。 Schemeだと次のように実装するのが綺麗なんじゃないでしょうか。pushは事実上consですね。ここは良し、とします。問題は
popですか。通常、恐らく大域変数stackをリストで作っておいて、破壊的変更を行う、ってのがこのテのコーディングの前提になるんでしょうが、それは避けます。あくまで関数型プログラミングの範疇で、破壊的変更しない前提で行きます。が、そうすると困ったことになるんですね。原則、
pushではstackは仮引数として与えてstackに何らかの操作をした結果を返せばいいわけですが、popの場合、「取り出した値を返す」のが大事なのか「操作した後のstackを返す」のが大事なのか分かりません。ってかどっちも大事なんですよね~。こう言う場合多値を用いて両者とも返しちゃう、ってのが一番Schemeらしいでしょう。そう言う実装方針で上のコードは掻きました。
次に示すような順番でスタックへ値を積んだり、スタックから値を取り出したりしてみます。
ここでは、図2のボール1をItem1、ボール2をItem2のように表すことにします。図2の動作例に従い、Item1、Item2、Item3の値を順にスタックへ積んだ(push)後、スタックから値を取り出します(pop)。このとき、一番上にある値はItem3なので、これが取り出されます。
次に、Item4、Item5の値を順にスタックへ積んでから、3回連続でスタックから値を取り出します。このとき、スタックの上から順に値が取り出されるので、Item5、Item4、Item2の順に出てきます。このタイミングでは、スタックにはItem1しか残っていないということになります。
最後に、ここへItem6を積んで、2回連続でスタックから値を取り出します。すると、Item6、Item1の順で値が取り出されます。では、ここで書いてあるような動作をテストするプロシージャ、
stacktestを実装してみます。こう言う場合、Schemeだとちょっと汚くなる、っつーかSchemeらしい書き方が難しいんですよね。何せ逐次実行が前提の言語じゃないんで、フラットに書くのが難しい。一方、所詮動作確認なんで、あんま面倒臭い事考えたくないんで、適当にベタ書きしてみます。
オリジナルのJavaコードに対応させようとすると、大体こんなカンジですかね。Javaなんかは由緒正しい「逐次処理言語」なんで、コードがフラットなんですが、Schemeの場合、特に今回は
popが多値を返す為にこう言うヘンなカンジにならざるを得なかったです。ポイントは
let-valuesで、popが多値を返し、最初の値(つまり取り出した値)を表示用のプロシージャ、displayに渡して表示させて、残りをstackとして次のプロシージャに渡すようになっています。では動作確認してみましょうか。
元ページのJavaコードの実行結果と同じになっていますね。確かにLIFOになっています。
仮想スタックマシンを実装する
すでに何度か説明しましたが、後置記法で表現された式というのは、スタックを使うと、非常に簡単に計算ができてしまいます。そして、このスタックというデータ構造を実現することは、これまでの説明からも分かるように、それほど難しくはありません。
さいでっか。じゃあ、次行きましょうか。
設計
オリジナルだとクラスだフィールドだメソッドだ、って書いてるんですが、Schemeにはんなモン無いんで無視します(笑)。そもそも大域変数を破壊的変更する設計にしないんで、フィールドとか要らんでしょ。
ただ、簡単化の為に次のヤツだけは受けます。
また、演算装置も用意します。これは、2つのパラメータを受け取って演算を行い、その結果を返すメソッドを持つAluクラスとして実装します。ALU(Arithmetic Logic Unit)は四則演算と論理演算を含むのが一般的ですが、ここではSvm1に必要な加算と乗算のみ用意することにします。そうそう、面倒だから取り敢えず加算と乗算のみやることにしましょう。追加は簡単ですしね。
演算装置
まあ、これは簡単ですね。オリジナルだとメソッドにしてますが、Schemeでは単純に独立したプロシージャとして実装します。ってか実装って程でもねぇんだけどな。まんまやん、まんま、そのまんまです。
プログラムを仮想スタックマシンへロード
さて、オリジナルではバイトデータのファイルでやり取りしてるんですが、どうしましょう。そもそもSchemeだとバイトデータの扱いが良く分からないし(そもそも仕様にないと思う)、オリジナルのバイトデータの仕様も良く分かりません。
しょーがないんで、プレーンテキストの読み込みに留めておきます。
そしてそのプレーンテキストへの記述の仕様ですが、
- 計算式は逆ポーランド記法とする
bipush命令は続くコードにある値をオペランドスタックに積む(push)iadd命令はオペランドスタックに積まれている値を2つ取り出して(pop)、それぞれの値を加算した結果をオペランドスタックに積むimul命令はオペランドスタックに積まれている値を2つ取り出して(pop)、乗算した結果をオペランドスタックに積むprint命令はオペランドスタックの一番上に積まれている値を出力する
とします。
具体的には、例えば、1 + 2 * 3の演算命令としては、基本的には逆ポーランド記法なので、1 2 3 * +になるわけですが、テキストファイルへの記述は
とします。
何だかインチキなアセンブリ言語みたいですが(笑)、取り敢えずこれを良しとして対象としましょう。構造さえ決まってしまえば、あとでどうにでも改造出来ますしね。
ってなわけで
とします。
何だかインチキなアセンブリ言語みたいですが(笑)、取り敢えずこれを良しとして対象としましょう。構造さえ決まってしまえば、あとでどうにでも改造出来ますしね。
ってなわけで
loadプロシージャを決まりきったカタチで実装します。ロードしたプログラムを実行
余談ですが、Schemeの最新の仕様書では繰り返し構文が増えています。他の言語ではお馴染みの
when(while)やunlessが搭載されました。繰り返ししたいけど特に終了時点で返したい値が無い場合重宝しますね。
ってなわけで
unlessを使った再帰でプロシージャexecuteを実装します。executeはexecutecommandを呼び出し、executecommandは多値を使ってexecuteとの間でcodeとstackをやり取りします。codeはexecutecommandによって「消費」され、計算の進行に従ってstackは(プログラミング用語ではない)状態を変化させていきます。命令を実際に解釈していくのはexecutecommandです。では
executecommandを実装していきます。命令の判定を実行
commandがbipushの場合は、続くコードにある値をオペランドスタックへ積む(push)する処理を行います。
commandがiaddの場合は、オペランドスタックに積まれている値を2つ取り出して(pop)、それぞれの値を加算した結果をオペランドスタックへ積みます。
commandがimulの場合は、iaddとほぼ同様の処理を行いますが、オペランドスタックへは取り出した値を乗算した結果を積むという点が異なります。
commandが
これをこのまま実装すると次のようになります。
先ほど書いた通り、
executecommandはexecuteと多値を用いてやり取りします。返り値はcodeとoperandstackの二種類です。仮想計算機もどきの実行
例として、次の3つのファイルを用意しておきます。
このプログラムで生成されたSvm1のオブジェクトコードを仮想スタックマシンSvm1で実行します。では、
svm1をでっち上げましょう。code0.svmには、「1 + 2」、code1.svmには、「1 + 2 * 3」、code2.svmには、「(1 + 2) * 3」を計算するオブジェクトコードが保存されていますから、実行結果はそれぞれ「3」、「7」、「9」となります。
はい、確かになっていますね。
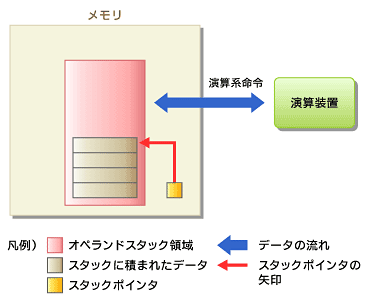
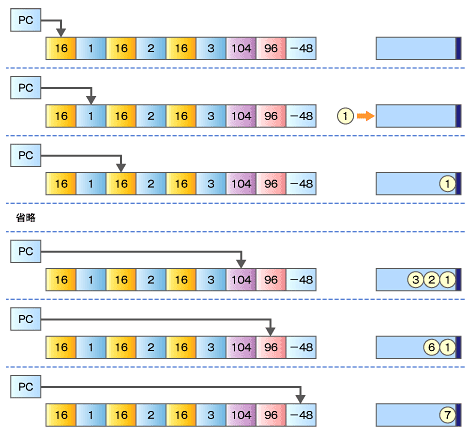
仮想計算機の実行例のイメージ
- 最初に、
bipushを読み込むと、次の値を読み込んでオペランドスタックへ「1」をpushしています。同様にして、「2」「3」をpushします(図では、省略しています)。 imulを読み込むと、オペランドスタックから値を2つpopして、それらを乗算し、その結果をオペランドスタックへpushします。iaddを読み込むと、オペランドスタックから値を2つpopして、それらを加算し、その結果をオペランドスタックへpushします。
どうでしょう、スタックを使うと簡単に仮想計算機をソフトウェアで実装することが分かったでしょうか。もちろん、Svm1は仮想計算機というには機能が少な過ぎますが、雰囲気はつかんでいただけたと思います。まあ、雰囲気はつかめましたね、確かに。
今回のソース
さあて、これ使うと色々な仮想計算機が作れる足がかりになるんでしょうかね。では今回のソースです。
2014年1月30日木曜日
SchemeでBrainfuckインタプリタ
さて、Scheme(Racket)でのBrainfuckインタプリタの作成です。
以前にも実は一回書いた事があるってばあるんですが、基本的なエンジンだけの作成で、キチンとしたREPL形式のインタプリタではなかったんですね。今回はキチンとしたスタンドアローンでREPL構造を持つBrainfuckインタプリタを実装してみたいと思います。
Scheme(R5RS)と例外処理
さて、完全なスタンドアローンのインタプリタを作ろう、って場合、例外処理が欠かせなくなります。何故なら入力が正しく行われなかった場合、システムが落ちてしまって、まあ、みっともないから、ですね。
ところで、Scheme(R5RS)互換でBrainfuckを記述しようとすると、大きな問題に次のような事があり得ます。
Brainfuckの場合、インタプリタと言っても、プロンプトに直接コードを打ち込む事はなく(あっても良いけどちとややこしい事が生じる)、基本的にはコードを記述したテキストファイルを読み込んで解釈実行する、ってスタイルです。つまり、REPLの中で「必ず」ファイルを開く動作を定義しなければなりません。
しかしそこでScheme(R5RS)だとややこしい状態が生じるんですね。「ファイルが存在しない」場合の挙動がイマイチ分からない。
つまり、Scheme(R5RS)だと基本的にファイルが存在しない場合はエラーを返し、そいつをまずはトラップすれば良いわけですが、ちとここでSchemeの通知するエラーとは何ぞや、と言う話が出てきます。(with-input-from-file string thunk) 省略可能手続き
string は,一つのファイルを指名する文字列であること。
(with-output-to-file string thunk) 省略可能手続き
そして,thunk は,引数をとらない手続きであること。
with-input-from-file では,ファイルが既存であること。
一方,with-output-to-file では,ファイルが既存だった
ときの効果は未規定である。入力または出力のためにファイ
ルが開かれ,それに接続された入力ポートまたは出力ポー
トが,current-input-port またはcurrent-output-port
によって返される(かつ(read),(write obj ) などで使わ
れる) デフォルト値へと仕立てられ,そしてthunk が無引数
で呼び出される。thunk が戻るときには,ポートが閉じられ
て以前のデフォルトが回復される。with-input-from-file
とwith-output-to-file は,thunk がもたらした(1個ま
たは複数個の) 値を返す。もしも脱出手続きが,これらの手
続きの継続から脱出するために使われるならば,これらの手
続きの振舞は実装依存である。
(open-input-file filename) 手続き
既存のファイルを指名する文字列を取り,そして,そのファ
イルからの文字を配送できる入力ポートを返す。もしもファ
イルを開くことができないならば,エラーが通知される。
1.3.2. エラー状態と未規定の振舞
エラー状態について言うとき,この報告書は“エラーが通知
される” という表現を使って,実装がそのエラーを検出し報
告しなければならないことを示す。もしあるエラーの議論に
そのような言い回しが現れないならば,実装がそのエラーを
検出または報告することは,奨励されているけれども,要求
されていない。実装による検出が要求されていないエラー状
態は,普通ただ単に“エラー” と呼ばれる。
たとえば,ある手続きにその手続きで処理することが明示的
に規定されていない引数を渡すことは,たとえそのような定
義域エラーがこの報告書でほとんど言及されていなくても,
エラーである。実装は,そのような引数を含めるように手続
きの定義域を拡張してもよい。
この報告書は“実装制限の違反を報告してもよい” という表
現を使って,実装の課すなんらかの制限のせいで正当なプロ
グラムの実行を続行できない,と報告することが実装に許さ
れている状況を示す。もちろん実装制限は望ましくないが,
実装が実装制限の違反を報告することは奨励されている。
たとえば実装は,あるプログラムを走らせるだけの十分な記
憶領域がないとき,実装制限の違反を報告してもよい。
もしある式の値が“未規定” (unspecified) であると述べられ
ているならば,その式は,エラーが通知されることなく,な
んらかのオブジェクトへと評価されなければならない。しか
し,その値は実装に依存する。この報告書は,どんな値が返
されるべきかを明示的には述べない。
実はR5RSに載ってる「エラーに関する記述」ってこれだけなんですよ(笑)。あれま。
いや、今まであんま考えて無かったんですが、良く使うエラー提示の"error"って関数も実は存在しなくってあれは実装依存だったんだ、とか今知った所存です(笑)。ダメじゃん(笑)。
つまり、R5RSに関する限り、「エラーを投げる」って事自体が実装依存にならざるを得ないんですね。こう言う事です。
- 自分で書いたコードに於いてエラーを通知する手段が用意されていない
- Schemeシステムが投げるエラーをトラップする手段がない
例外処理、と言うのは基本的には「出てきたエラーに対して適切な手段を提示する」わけなんですが、R5RS範疇では「どういうエラーが提示されてるのか」判別する手段が無い。つまり、この辺りは全部Schemeの下のレイヤーで決定されてる、って事になります。
例えばRacketの場合だと、存在しないファイルを開こうとすると、
なんて返してくるわけですが、一体これをどうやってトラップするのか?Racketだとexnと言う構造体が定義されていて、それを利用してこの場合、exn:fail:filesystem:errnoと言うブツを返すらしいんですが、こんなのが他のシステムにも採用されてる保証はない(Pythonみたいに例外クラスをOOPで定義されてる場合も当然あるでしょう)。これはSRFI34、SRFI35、SRFI36とか使っても本質的に解決出来る問題だとは思えないのです。
つまり、この辺がR5RSのポータビリティの限界ですね(笑)。もちろん上のSRFIなんかでも上手くラップしてるのかもしれませんが、エラー定義がシステムの内部依存になってるとすれば、おとなしく(笑)システム依存の例外処理機構使った方が良さそうです。
何か負けた気もするんですが(笑)、今回は諦めて、例外処理に関してはRacketが提供しているwith-handlersをおとなしく使う事にします(苦笑)。
Brainfuckの仕様
まあ、当然知ってる人は知ってるでしょうが、Wikipediaの方から改めてBrainfuckの仕様を抜書きしてみます。
>ポインタをインクリメントする。ポインタをptrとすると、C言語の「ptr++;」に相当する。<ポインタをデクリメントする。C言語の「ptr--;」に相当。+ポインタが指す値をインクリメントする。C言語の「(*ptr)++;」に相当。-ポインタが指す値をデクリメントする。C言語の「(*ptr)--;」に相当。.ポインタが指す値を出力に書き出す。C言語の「putchar(*ptr);」に相当。,入力から1バイト読み込んで、ポインタが指す先に代入する。C言語の「*ptr=getchar();」に相当。[ポインタが指す値が0なら、対応する]の直後にジャンプする。C言語の「while(*ptr){」に相当。]ポインタが指す値が0でないなら、対応する[(の直後[1])にジャンプする。C言語の「}」に相当[2]。
さて、Scheme的に言うと1から6までが「関数」(手続き)そして7番と8番は「特殊形式」(構文、あるいはシンタックス)になりますね。実は1から6までは実装はハナクソなんですが、7と8がややこしい。一体これをどうやってプログラムするのか。
今までParser自体は書いた事があんま無いわけですが、要するにRead部分でBrainfuckのプログラムファイルを読み込んだ時点で、どうやらジャンプ先の候補ってのをマーキングしておいて、それを「パーズと称して」(笑)Evalに渡さなければならないみたいです。この辺はEvalでやる事じゃあなさそうですね。ではやってみますか。
Read の実装
まずはファイルを読み込む関数(read-file)を実装していきます。仕様は次の通りとします。
- ファイルを開く。
- ストリームから一文字ずつread-charする。その度にカウンターを+1する。
- 文字が>、<、+、-、.、,の場合はcodeにconsする。
- 文字が[の場合はlsにカウンターの値をpushする。
- 文字が]の場合はlsの値をpopして、stackにカウンターの値と(car ls)のペア、(car ls)とカウンターの値のペアをpushする(つまり、stackは連想リストとする)。lsに対応する[の位置情報が無い場合、「カッコの数が合致してない」んでエラーを返す。
- 文字がこの8種類以外の場合は無視してread-charする。
- ファイル終端に来た場合、ls内に位置情報が残ってる場合、「カッコの数が合致してない」んでエラーを返す。lsが空リストだったら多値として(reverse code)と連想リストstackの二値を返す。
さて、read-fileを書き上げたら Read 部本体である parser (実際は parse は read-file がやってるんですが・笑)関数を実装していきます。これは今までのゲームの例のように、インタプリタの現状(phase)に合わせて動作を変更します。次が parser の仕様です。
ゲームの場合もそうですが、「受け取った何らかの入力は」 x に束縛して、それ以外 Read は特に何もやりません。唯一の例外は、 read-file に構文解析させた情報を code と stack に積むのみ、だけですね。あとは phase 情報に従って適切な読み込み系関数を探して実行するだけ、となります。
では Eval を見て行きましょう。
と言うのも、今までのゲームと違って、今回の brainfuck インタプリタの場合、全体的にREPLとしてイベントループを形成するのはもちろんですが、一旦コードが読まれると基本的には Eval 内で繰り返し処理してから Print 部に渡す為、 phase がどういうステージを持つのかハッキリしないとちと混乱してくるからです。
(しかも、Eval 自体でのループの際、 .命令と,命令があった場合、一旦ループを中断して、Print部とRead部の助けを借りないとならない)
. では一旦 interp 関数のループを止めて、ポインタの指すメモリの値を Print 部に渡さないとなりません。
手順としては、
- 関数 parser は x、 phase、 counter、 code、 pointer、 memory、 stackの7つの引数を受け取る関数とする。
- parser は phase に従ってその挙動を変えるものとする。なお、phaseの中身は基本的にはシンボルである。
- phase が 'read-file だった場合、ユーザーからプロンプトを通じてファイルパスを受け取り、その引数を関数 read-file に受け渡し、返り値を受け取り、多値としてx、 phase、 counter、 code(これは read-file が返したもの)、 pointer、 memory、 stack(これも read-file が返したもの)の7つを返す。
- phase が 'read-char だった場合、ユーザーからプロンプトを通じて1文字だけ受け取りそれを新たに x として x、 phase、 counter、 code、 pointer、 memory、 stack の7つの値を多値として返す。
- phase が read だった場合、ユーザーからプロンプトを通じて何か受け取り、それを新たに x として x、 phase、 counter、 code、 pointer、 memory、 stack の7つの値を多値として返す。
- それ以外の場合は基本的にスルーして、 x、 phase、 counter、 code、 pointer、 memory、 stack の7つの値をそのまま多値として返す。
ゲームの場合もそうですが、「受け取った何らかの入力は」 x に束縛して、それ以外 Read は特に何もやりません。唯一の例外は、 read-file に構文解析させた情報を code と stack に積むのみ、だけですね。あとは phase 情報に従って適切な読み込み系関数を探して実行するだけ、となります。
では Eval を見て行きましょう。
Eval の実装
まず、Eval の実装を始める前に、インタプリタの動作の振る舞いを決定するステージ、 phase がどんなものになるか決めてしまいましょう。と言うのも、今までのゲームと違って、今回の brainfuck インタプリタの場合、全体的にREPLとしてイベントループを形成するのはもちろんですが、一旦コードが読まれると基本的には Eval 内で繰り返し処理してから Print 部に渡す為、 phase がどういうステージを持つのかハッキリしないとちと混乱してくるからです。
(しかも、Eval 自体でのループの際、 .命令と,命令があった場合、一旦ループを中断して、Print部とRead部の助けを借りないとならない)
- introduction ステージ: インタプリタを起動した際にアプリケーションが自己主張するステージ(まあ無くても良いんですが・笑)
- read ステージ: 何らかの入力を外部から読み込むステージ
- read-file ステージ: Brainfuck プログラムファイルを読み込むステージ
- read-char ステージ: 一文字だけ入力を外部から読み込むステージ
- put-char ステージ: 一文字だけ表示するステージ
- execute ステージ: Brainfuck プログラムを評価するステージ
- break ステージ: 何らかのエラーによってプログラムの実行が中止されたステージ
- exception ステージ: エラーに関する表示を行うステージ
基本的には上の8つとなります。
それで、ステージがイベントループの中核になるわけですが、基本的な流れは
introduction -> read -> read-file -> execute -> read -> read-file -> execute -> ...
と言うカンジで、初回だけ introduction が出てきますが、あとは read -> read-file -> execute -> の繰り返しです。 execute 内でたまに、read-char ステージかあるいは put-char ステージが求められる、と言う考え方です。
なお、break ステージだけは Eval が設定しません。これは後で例外処理機構が例外を処理した際に設定するステージとしましょう。それを Eval が見て、exception ステージを設定する、と言う考え方で実装します。
では以下に Eval の簡単な仕様を提示します。
- Eval(interp 関数) は x、 phase、 counter、 code、 pointer、 memory、 stack、の7つの引数を受け取る関数とする。
- phase が 'introduction だった場合 phase を 'read に変更し、x、 'read、 counter、 code、 pointer、 memory、 stack、の7つを多値として返す。
- phase が 'read だった場合、
- x(入力値)がquit、exit、または bye だった場合、brainfuck インタプリタを終了する。
- x が load、 open、 または read-file だった場合、phase を 'read-file に変更し、x 'read-file counter code pointer memory stack の7つを多値として返す。
- それ以外の場合はスルーして、 x、 phase、 counter、 code、 pointer、 memory、 stack の7つを多値としてそのまま返す。
- phase が 'read-file だった場合、BrainfuckコードがRead部から読み込まれた事を意味する。すなわち、phase を 'execute に設定し、再帰的に自身を呼び出す。具体的には x、 'execute、 counter、 code、 pointer、 memory、 stack、を7つの引数として interp 関数を呼び出す。
- phase が 'read-char だった場合、pointerが指すメモリの値に 入力値 x を整数に変換した値を足して、phase を 'execute に変更して自身を呼び出す。
- phase が 'put-char だった場合、出力が終了した事を意味する。従って、phase を 'excute に変更して自身を呼び出す。
- phase が 'execute だった場合、次のように動作する
- counterの値がcodeの長さと一致した場合、Brainfuckコードの解釈実行が終了した事を意味する。すなわち初期化として #f、 'read、 0、 #f、 0、 '(0 . 0)、 '()、の7つを多値として返す。
- 1でなければ counter の指す code の値を解釈実行する。すなわち、Brainfuckの仕様に従って動作する。
- phase が 'break だった場合、phase に 'exception を設定して、x、 'exception、 counter、 code、 pointer、 memory、 stack、の7つを多値として返す。
- phase が 'exception だった場合、Brainfuckインタプリタシステムがエラー報告をユーザーに行い終わった事を意味する。従って初期化として #f、 'read、 0、 #f、 0、 '(0 . 0)、 '()、の7つを多値として返す。
- それ以外の場合は phase に 'introduction を設定して、x、 'introduction、 counter、 code、 pointer、 memory、 stack の7つを多値として返す。
これが基本動作です。
さて、実際はもっと具体的に5-2がどういう事を行うか、なんですが、ちょっと説明しましょう。
基本的には「全く破壊的操作を行わない」Brainfuck仕様を考えています。Wikipediaの説明を見ると、Brainfuckで扱うメモリとは
Schemeには連想リストがあるんで、これをメモリに見立ててみれば良い、と言う事です。
つまり初期値として memory と言う引数には '((0 . 0)) と言う「連想リスト」を与えてます。これは「メモリゼロ番地で、初期値は0」と言う意味合いに対応しています。
>と言う命令を見た時、pointerを1増やすわけですが、その時、平たく言うと memory に '(1 . 0) と言うペアをconsしてやる。そうすれば memory は '((1 . 0) (0 . 0)) と言う状態になって、二つの記憶域を持つ状態になります。もう一回 > があれば今度は memory は '((2 . 0) (1 . 0) (0 . 0)) と言う状態になりますね。
つまり、実質的には > は memoryに (pointer . 0) と言うペアを cons する関数だ、と捉え直す事が出来るのです(もちろん、既にポインタが指すペアが存在する場合は新たにペアを cons する必要はありません)。
+、-は pointer の指す memory を assv して、その cdr に対して加算(+1)ないしは減算(-1)を行います(これを datum とする)。ただし、ここでも破壊的変更を避ける為、memoryから対象のペアを削除して(この削除は破壊的削除ではない)新しく作ったペアを cons します。
さて、実際はもっと具体的に5-2がどういう事を行うか、なんですが、ちょっと説明しましょう。
基本的には「全く破壊的操作を行わない」Brainfuck仕様を考えています。Wikipediaの説明を見ると、Brainfuckで扱うメモリとは
少なくとも30000個の要素を持つバイトの配列(各要素はゼロで初期化される)となってるんですが、そこはSchemeなんで別に上限値を設定する必要はありません。ではどうするのか。
Schemeには連想リストがあるんで、これをメモリに見立ててみれば良い、と言う事です。
つまり初期値として memory と言う引数には '((0 . 0)) と言う「連想リスト」を与えてます。これは「メモリゼロ番地で、初期値は0」と言う意味合いに対応しています。
>と言う命令を見た時、pointerを1増やすわけですが、その時、平たく言うと memory に '(1 . 0) と言うペアをconsしてやる。そうすれば memory は '((1 . 0) (0 . 0)) と言う状態になって、二つの記憶域を持つ状態になります。もう一回 > があれば今度は memory は '((2 . 0) (1 . 0) (0 . 0)) と言う状態になりますね。
つまり、実質的には > は memoryに (pointer . 0) と言うペアを cons する関数だ、と捉え直す事が出来るのです(もちろん、既にポインタが指すペアが存在する場合は新たにペアを cons する必要はありません)。
注: なお、実際はペアを使って cons するのではなく、SRFI1のalist-consを使って cons していきます。反面、 < は「既に > が作成したメモリ」をたどっていくだけなので新しいメモリ(のペア)を作成する事はありません。単純に pointer の値を -1 するだけです。
注: なお、本当は上の機構を使えば負の番地を持つメモリも実装可能ですが、今回は敢えてやっていません。pointer の値が負になるとエラーを返します。
+、-は pointer の指す memory を assv して、その cdr に対して加算(+1)ないしは減算(-1)を行います(これを datum とする)。ただし、ここでも破壊的変更を避ける為、memoryから対象のペアを削除して(この削除は破壊的削除ではない)新しく作ったペアを cons します。
注 : 具体的には、Eval( interp 関数)が引数として memory を保持してるので、再帰過程に於いて SRFI1 の alist-delete を使って対象ペアを除いたカタチで memory を取り出し、それに対して pointer と計算し終わったdatum を alist-cons する。すなわち書式は
(alist-cons pointer datum (alist-delete pointer memory))
となる。
手順としては、
- phase を 'put-char にしてループを抜ける宣言をする。
- (integer->char (cdr (assv pointer memory))) の値を x に束縛して x、 'put-char、 counter + 1、 code、 pointer、 memory、 stack、の7つを多値として返す。
です。
でこっちは滅多にないんですが、,命令も.に似てますね。
- phase を 'read-char にしてループを抜ける宣言をする。
- すなわち、 x、 'read-char、 counter + 1、 code、 pointer、 memory、 stack、の7つを多値として返す。
phase が 'put-char、あるいは 'read-char の場合は既に書きました。基本的には phase に 'executeをセットしなおして自身を再帰呼び出しするだけです。ただし、 read-charモードの場合はメモリに入力値を加算しないといけませんが、前述した通り、SRFI の alist-delete と alist-cons を上手く使って破壊的操作を回避します。
最後はループ命令です。
[を見た時、
具体的な話をすると、 stack も連想リストです。これはRead部でread-fileが解析したジャンプ対象の位置情報が入っています。
例えばBrainfuckの何らかのプログラムの4つ目に[があって、41個目に]があった場合、stackは '((4 . 41) (41. 4))と言うカタチで対応を保持しています。そして実行部である Eval (interp 関数)では、code の4つ目で [ を見た場合 (cdr (assv pointer memory)) の値が 0 であるかどうかをチェックして、そうだった場合、カウンターを一気に41へ(正確には]の後ろなんで42)進めます。
]の場合は、無条件に stack が提示する [ の位置へとカウンターを「戻し」ます。先ほどのケースで、stackが'((4 . 41) (41. 4))だった場合、counterが41なんでcounterを (cdr (assv counter stack)) に従って4に戻して interp 関数は自分を再帰呼び出しします。
と言うわけで、Eval ( interp 関数)のコードは以下の通りです。
では最後にPrint部です。
Print部に直接関連した phase は
まずは大域変数 *messages* を設定します。
1、2、3のケースだと単純に (cdr (assq phase *messages*)) を表示すれば良いだけですし(何のために *messages* のキーと phase の値に互換性を持たせてるのか、と言うとこの為です!)、4、5の場合は Eval ( interp 関数)が渡してきた x を表示すれば良い。あとは、プロンプトを表示するだけなんで、Print 部は次のように簡単に書けます。
これで、BrainfuckのREPL各部位は完成しました。あとは実際REPLとして組み上げるだけです。
平たく言うと、REPL部でそれをやってしまおう、って事です。
まずは、例外処理無しのREPLをひな形として組んでみます。
これでも充分動くんですが、例えば「存在しないファイル」を開こうとすると当然エラーが出てシステムは落ちてしまいます。
システムが落ちる、とはどういう事か。継続よろしく、エラーと言うのは発生するとトップレベルに強制的に戻される(つまり関数内から抜ける)、って事になるわけですね。
つまり、言い方を変えると、例外処理と言うのはトップレベルに戻る前にそのエラーをまずは「捕まえる」仕組みです。そして捕まえたらそのエラーの種類に従って、適切な処置を施す。
この場合、REPL内でエラーが投げられるわけですが、どういう処理が必要かと言うと、大枠的には「REPL内に戻る」事になります。何故かと言うとインタプリタ内でエラーが起きて別のプログラムが走ったりすればこれは困ります(笑)。インタプリタでエラーが起きたらインタプリタに戻って欲しい。
言い換えると
ってのが「エラーに対する適切な処置」になるわけです。
基本的にはどんなエラーが起きてもインタプリタに戻って構わないんですが、一応「どんなエラーが起きたか」ユーザーに示さないといけない(利便性の問題です)。その為に「どんなエラーが起きたのか」知る必要があって、その為のエラートラップになるわけですね。
今まで組み上げたプログラムを見ると(想定された)エラーの種類、ってのは次の通りです。
最後はループ命令です。
[を見た時、
- pointer が指すメモリの値、すなわち (cdr (assv pointer memory)) が0なら stack から counterから飛べる値を探してきて、counter にその値をセットして自身を再帰呼び出しする。
- そうじゃないなら、counterを+1してそのまま処理を継続する。
具体的な話をすると、 stack も連想リストです。これはRead部でread-fileが解析したジャンプ対象の位置情報が入っています。
例えばBrainfuckの何らかのプログラムの4つ目に[があって、41個目に]があった場合、stackは '((4 . 41) (41. 4))と言うカタチで対応を保持しています。そして実行部である Eval (interp 関数)では、code の4つ目で [ を見た場合 (cdr (assv pointer memory)) の値が 0 であるかどうかをチェックして、そうだった場合、カウンターを一気に41へ(正確には]の後ろなんで42)進めます。
]の場合は、無条件に stack が提示する [ の位置へとカウンターを「戻し」ます。先ほどのケースで、stackが'((4 . 41) (41. 4))だった場合、counterが41なんでcounterを (cdr (assv counter stack)) に従って4に戻して interp 関数は自分を再帰呼び出しします。
と言うわけで、Eval ( interp 関数)のコードは以下の通りです。
では最後にPrint部です。
Print の実装
Print部は相変わらず簡単です。単純に言うとメッセージを大域変数で連想リストとして設定して、phase の条件に従ってassvで検索したペアの cdr を表示すれば良い。そしてその後、返り値を返します。Print部に直接関連した phase は
- introduction
- read-char
- read-file
- put-char
- exception
の5つで、そのうち1、2,3は纏められて、4、5も纏められます。
まずは大域変数 *messages* を設定します。
1、2、3のケースだと単純に (cdr (assq phase *messages*)) を表示すれば良いだけですし(何のために *messages* のキーと phase の値に互換性を持たせてるのか、と言うとこの為です!)、4、5の場合は Eval ( interp 関数)が渡してきた x を表示すれば良い。あとは、プロンプトを表示するだけなんで、Print 部は次のように簡単に書けます。
これで、BrainfuckのREPL各部位は完成しました。あとは実際REPLとして組み上げるだけです。
REPL と例外処理
まあ、前からやってる通り、単純にはSchemeのSRFI11を利用して多値関数同士を結んで末尾再帰でREPLを書くだけで良いんですが、各関数(っつーかReadとEval)は場合によっては例外を throw しますが、一方、例外を catch してシステムを安全にする機構は組み上げてません。平たく言うと、REPL部でそれをやってしまおう、って事です。
まずは、例外処理無しのREPLをひな形として組んでみます。
これでも充分動くんですが、例えば「存在しないファイル」を開こうとすると当然エラーが出てシステムは落ちてしまいます。
システムが落ちる、とはどういう事か。継続よろしく、エラーと言うのは発生するとトップレベルに強制的に戻される(つまり関数内から抜ける)、って事になるわけですね。
つまり、言い方を変えると、例外処理と言うのはトップレベルに戻る前にそのエラーをまずは「捕まえる」仕組みです。そして捕まえたらそのエラーの種類に従って、適切な処置を施す。
この場合、REPL内でエラーが投げられるわけですが、どういう処理が必要かと言うと、大枠的には「REPL内に戻る」事になります。何故かと言うとインタプリタ内でエラーが起きて別のプログラムが走ったりすればこれは困ります(笑)。インタプリタでエラーが起きたらインタプリタに戻って欲しい。
言い換えると
エラーが起きた -> でもインタプリタ(REPL)に戻る
ってのが「エラーに対する適切な処置」になるわけです。
基本的にはどんなエラーが起きてもインタプリタに戻って構わないんですが、一応「どんなエラーが起きたか」ユーザーに示さないといけない(利便性の問題です)。その為に「どんなエラーが起きたのか」知る必要があって、その為のエラートラップになるわけですね。
今まで組み上げたプログラムを見ると(想定された)エラーの種類、ってのは次の通りです。
- read-file 内で起きた「ファイルが見つかりません」エラー
- read-file 内で起きた「カッコの数が合いません」エラー
- eval内で起きた「pointerの値が負の数です」エラー
この3つが想定されてるエラーです。1番はScheme(より正確に言うとRacket)組み込みのエラー、2番と3番はプログラマ側が決めたエラーです。
( with-handlers ((述語 エラー処理) ...) (本体))
つまり、まず構文的には、(let-values ... で形成されたREPLの本体を(with-handlers で包んでやれば良い、って事になる。
加えると、述語なんですが、要するにこれがエラー種類を判定する述語です。
先にも書きましたが、1. のケースだとRacket自体が「どういう種類のエラーなのか」定義してる部分で、これはプログラマ側でどーにか変更する、ってモノじゃありません。リファレンスで調べなきゃいけない範疇となります(笑)。で、exn:fail:filesystem:errno ってのがそのエラーの型で exn:fail:filesystem:errno? がその述語になります(ちなみに exn 自体は変数扱いになるようです)。
2番と3番がプログラマ側が定義したエラーで、raise で定義した・・・事実上、定義したエラーになります。何を定義したのか、と言うと raise に与えた引数がその型を定義してる、って言って過言じゃないです。何故 read-file や interp で使った raise にシンボルを引数として与えたのか、と言う理由がここにあります。
と言うのも、シンボルを引数にして与えた raise によるユーザー定義のエラーの場合、述語は単純にラムダ式となって
(lambda (v) (eq? '何かのシンボル v))
と書ける。一般にSchemeを含むLisp族はシンボルはユニーク(単一しか存在し得ない)である事が保証されていて、しかも eq? による比較は高速で決着が付く。これを考えると raise する場合は圧倒的にシンボルを引数に与えた方が得だ、って事になりますね。
つまり、組み込みエラーの場合は ext がシンボルなんでエラー処理部分のラムダ式の引数は ext 、他の場合は自分で決めたもの、例えば述語部位が v を使ってたらエラー処理部分のラムダ式の引数も v にする、って事ですね。
さて、さっきも書いた通り、エラー処理自体は「REPLに戻るのが前提」と書きました。ここで整理すると、
- x はPrint部の為に「こう言うエラーが起きました」と言う文字列情報を入れる。
- phase は 'break にセットする。
- あとの引数は(どの道 Eval が初期化する前提なんで)手を付けない。
- 以上の情報を持ってREPLを再度呼び出す
となります。つまり、エラー処理のラムダ式は原則
(lambda (引数) (repl エラー情報文字列 'break counter code pointer memory stack))
になる、って事を意味します。
これを考慮してREPLを修正します。
これで、仮に「存在しないファイル」をREPLで開いた場合でも、Brainfuckインタプリタは落ちないで、そのまま処理を継続します。
以上でBrainfuckインタプリタの完成です。以下に全コードを載せておきます。
Racket で実行形式作成
以前から Racket には raco と言うコンパイラが付属してたんですが、コマンドラインツールだし、何かメンドくせえし(笑)、とかでスタンドアローンでの実行形式作るのは諦めてたんですね。しかし最近、とうとう DrRacket IDEからメニューから選んで実行形式が作れるようになる、と大進歩を遂げました。Lisp系言語だと「スタンドアローンは作りづらい」って言われてたんですが、ここに来てやっとLispプログラムの恩恵を一般に配布しやすくなった、って言って良いでしょう。
ただ、残念なのは、どうもユニコードの問題があって、日本語なんかの文字列が入ってるとコンパイラが通ってもすぐ落ちたりしちゃうんですね(今回、メッセージ表記を全て英語にしたのはそのせいです)。
ファイルを保存してからDr.Racketの [Racket] メニューから [実行ファイルの作成...]を選びます。

そうするとポップアップメニューが現れます。

Typeに関しては一番下のDistributionを使えば良いでしょう。と言うのも、これがアプリの配布形式を作るブツだからです。
注: 一番目のブツは平たく言うとエイリアスを作るだけで、コンパイルして実行形式を作るとはいえない。二番目はコンパイルは行うが、その実行にはRacket本体が必要で、要するにいわゆる「ランタイム」を含めた実行形式を作成するには3番目のDistributionしかなく、配布目的、あるいは完全なスタンドアローンを作るならこれを利用するしかなくなる。
BaseもRacketを使えば良いです(GRacketはRacket(コマンドライン版)のちょっとしたGUI版程度です)。
あとは [作成] ボタンを押せば自動的に実行形式を含むzipファイルを作成してくれます(圧縮までしてくれるたぁ何て親切・笑!)
Brainfuck の大きさ
Wikipediaによると開発者Urban Müllerがコンパイラがなるべく小さくなる言語として考案した。 実際、Müllerが開発したコンパイラのサイズはわずか123バイト、インタプリタは98バイトであった。なんだそうなんですが、Schemeで書いたBrainfuckインタプリタの実行形式は何と5.09メガバイトもありました(笑)。何と53倍弱の大きさです(笑)。いやあ、富豪の時代ですねぇ(笑)。
これ、twitterでも笑って言ってたんですが(笑)。5.09メガバイトって事はフロッピーディスク一枚に収まらないんですよ(笑)。何枚くらいになるんだろ・・・まあフロッピー四枚くらいで、90年代前半だとゲームで多くてフロッピー二枚、四枚なんて殆どOS並の「大きさ」なんです。
これやってみたらやっぱ長い間Lisp系言語が人気無かったのは分かりますね。Brainfuckくらいの単純なインタプリタでも書いちゃうとOS並の大きさになっちゃう、ってのは20年くらい前のPCだとマジで死活問題です(笑)。いやあ、今の時代は良い時代ですねぇ(笑)。
ってなわけで、実行形式へのリンクも貼っておきますね。
登録:
投稿 (Atom)


 投稿

